比赛已经提交,终于可以把这段时间散落在配置、日志和聊天记录里的东西整理一下。
这次我们以 北京大学武汉人工智能研究院 团队参与比赛,使用 LingBot-VLA 2.0 6B,在 RoboTwin 的 Aloha-AgileX clean 数据上做 post-training,也提交了两个 UR 真机操作 Demo(还有一个叠衣服的任务,但由于网络问题推理测试速度太慢没有提交)。整个过程涉及数据适配、归一化、训练增广、多 GPU 评测,以及最后的复现材料整理。
值得记下来的,除了训练参数,还有那些让流程真正跑通的细节:为什么不加载图像的统计脚本仍然很慢,为什么多相机增广要共享参数,以及评测中断后应该怎样统计结果。
数据准备
训练使用 RoboTwin 2.0 Aloha-AgileX clean 50 数据集:50 个任务,每任务 50 条示范,共 2500 条轨迹。转换后的元数据合计为 549787 帧。
处理流程如下:
RoboTwin 原始 HDF5 + 指令
    ↓ 官方 process_data_pi0.sh
中间数据
    ↓ convert_aloha_data_to_lerobot_robotwin.py
LeRobot 数据集
    ↓ clean 专用任务清单 + 归一化统计
LingBot-VLA 多任务训练
这里单独维护了 assets/training_data/robotwin_clean.txt。原仓库的数据清单同时包含 clean 和 randomized,直接沿用容易把训练数据范围弄错。本次只使用 clean 示范,randomized 留作评测。
转换脚本对目录结构有自己的约定。原始数据位于 assets 目录时,需要先适配到转换器期望的路径。另外,转换器会重新生成同名输出目录,重跑之前要确认目标位置,避免覆盖已有数据。
机器人映射也需要和数据一起固定下来。RoboTwin 的手臂关节、夹爪状态与三路相机,通过 robot config 接入模型的统一表示。配置里的 action_dim: 55 是每个时间步的统一动作表示维度;预测序列长度由 chunk / horizon 参数决定,本次使用 50。
归一化计算
数据准备后,先计算 clean 专用的归一化统计。第一次运行在初始化完 50 个数据集后,长时间停在首个 batch。
最初查到的是线程过量:8 个 worker 各自有 144 个线程。限制 OMP、MKL、OpenBLAS 等线程数,再把 worker 调到 2 个后,程序可以推进,但仍然大约需要 20 秒一个 batch。
继续往下查,问题出在图像解码。
虽然统计时设置了 load_image=False,跳过了显式视频加载,但 Parquet 里内嵌的相机图像仍然会在 Hugging Face Dataset 读取行和查询动作窗口时自动解码。统计只需要状态和动作,图像却仍在消耗时间。
最终在 base_dataset.py 中,对不加载图像的模式提前移除相机列。单数据集验证时,读取 48 个样本、每个动作窗口 50 步,耗时约 0.072 秒;同时抽查了索引 0、1、47 的状态和当前动作,与原始 Parquet 一致。这个数字只对应局部读取测试,不能当作全量统计耗时。
这次排查留下了一个很实用的经验:性能问题要追到实际访问的数据列。配置里关闭某项功能之后,还要确认底层读取路径是否真的停止了对应工作。
最终训练使用 clean 专用的 robotwin_clean.json,归一化方式为 bounds_99_woclip:
x_norm = 2 × (x - q01) / (q99 - q01 + 1e-6) - 1
它按每维的 1% 和 99% 分位数缩放,不做截断。复现时需要同时保留数据清单、robot config 和统计文件,才能让动作的归一化与反归一化对应起来。
clean 数据上的在线图像增广
这次主要的调优方向,是在 clean 示范上增加视觉扰动,尝试扩大模型训练时看到的外观变化,目的是想提高模型在random setting下的表现SR,因为在clean setting下想要提高就得不断过拟合,所以。
增广在训练读取时在线执行,不改写原始视频或 Parquet,状态、动作标签保持不变,也没有额外引入 randomized 示范。
| 扰动类型 | 主要设置 |
|---|---|
| 颜色变化 | 亮度、对比度、饱和度与色温扰动 |
| 图像噪声 | 高斯噪声、椒盐噪声 |
| 模糊 | 轻微高斯模糊或运动模糊 |
| 几何变化 | 小范围裁剪、平移和缩放 |
| 遮挡 | 小面积中性灰遮挡 |
| 压缩 | JPEG 压缩伪影 |
实现中需要特别处理的是多相机和时序一致性。同一个样本的顶部相机、左右腕部相机,以及当前帧、未来帧共享增强参数;深度教师和视频教师也使用同样增强后的图像。
这样做是为了减少额外的监督错位。如果当前图像被裁剪,未来图像或教师输入却保留原样,模型还需要适应人为引入的不一致。共享参数可以保持扰动方式一致,但并不代表二维图像增广具备严格的三维几何一致性。
其实做这部分内容之前也参考过openpi的一些实现,但我总觉得他们的实现偏保守,不够彻底,既然要做就得做得彻底一点,看一下到底会不会影响到模型学习的分布。
评测时关闭训练增广。具体实现位于 lingbotvla/data/vla_data/image_augmentation.py,默认强度与概率记录在项目的增广说明中。
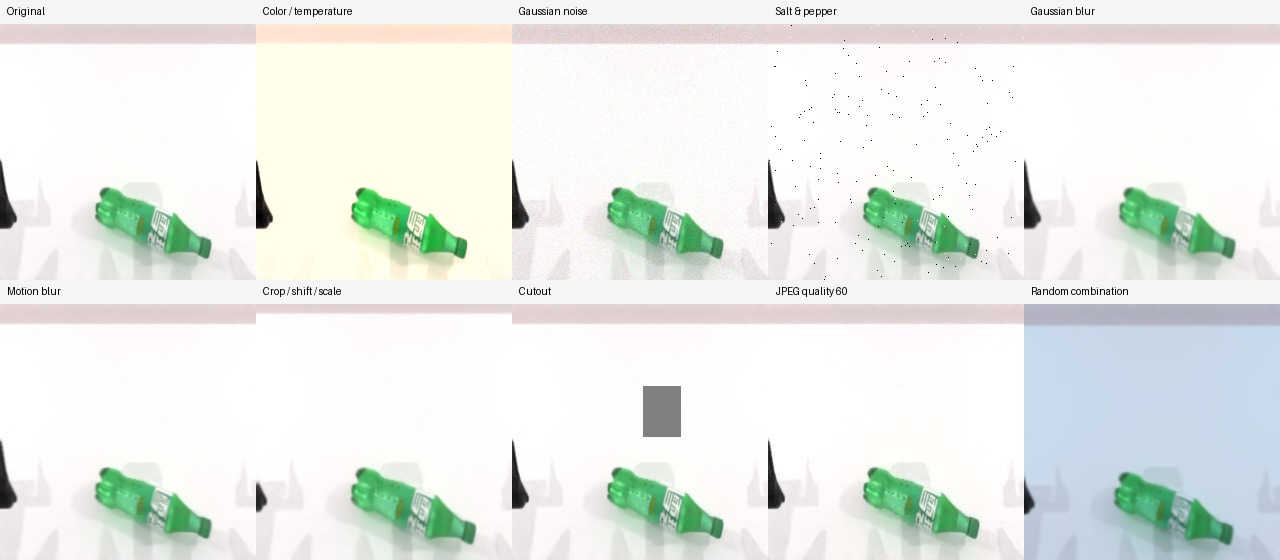
图中展示原始图像及各类扰动,便于直观看到训练时增加了哪些外观变化。
双卡训练配置
训练在双卡B200上提交,主要参数如下:
| 参数 | 最终提交对应设置 |
|---|---|
| 基础模型 | LingBot-VLA 2.0 6B |
| GPU 数 | 2 |
| Micro batch / 梯度累积 | 32 / 4 |
| Global batch | 256 |
| 优化器 | Muon |
| 学习率 | 1e-4,cosine 衰减至 5e-5 |
| Warmup ratio | 0.03 |
| Loss | L1_fm |
| 训练预算 / 保存间隔 | 24000 步 / 4000 步 |
| 提交 checkpoint | global_step_12000/hf_ckpt |
有效 batch 的关系是:
32 × 2 GPU × 4 次梯度累积 = 256
因此,比较实验时只看训练步数不够,还要看 global batch、数据采样方式和学习率计划。
另一个容易混淆的参数是 L1_fm。在本项目实现中,它对 flow matching 的目标速度与预测速度计算 L1,目标为 noise - actions。它的 loss 数值不能直接解释为最终动作误差,也不适合与使用 MSE 的 fm 数值直接比较优劣。
模型沿用基础模型的 MoE、深度与未来视频对齐机制。本次工作主要集中在数据处理、训练配置和评测适配。
两阶段方案实际执行到了哪里
原计划先开启增广训练,再从该权重继续做关闭增广的原图微调,希望在视觉覆盖与动作精度之间找到更合适的平衡。
时间最终只够完成第一阶段的训练与提交准备。第二阶段没有执行,也没有形成“无增广、仅增广、两阶段”的完整消融。因此,本文记录的是这条调优思路及第一阶段实践,尚不能给出第二阶段收益或增广提升幅度的结论。
训练 loss 曲线
项目保留了多轮实验的 loss、学习率、梯度范数及辅助任务指标。这里放入两组 RoboTwin 历史实验,记录训练过程;它们不是最终 batch 256、12000 步提交权重的训练曲线,也不是严格控制变量的对照实验。
早期 RoboTwin 实验
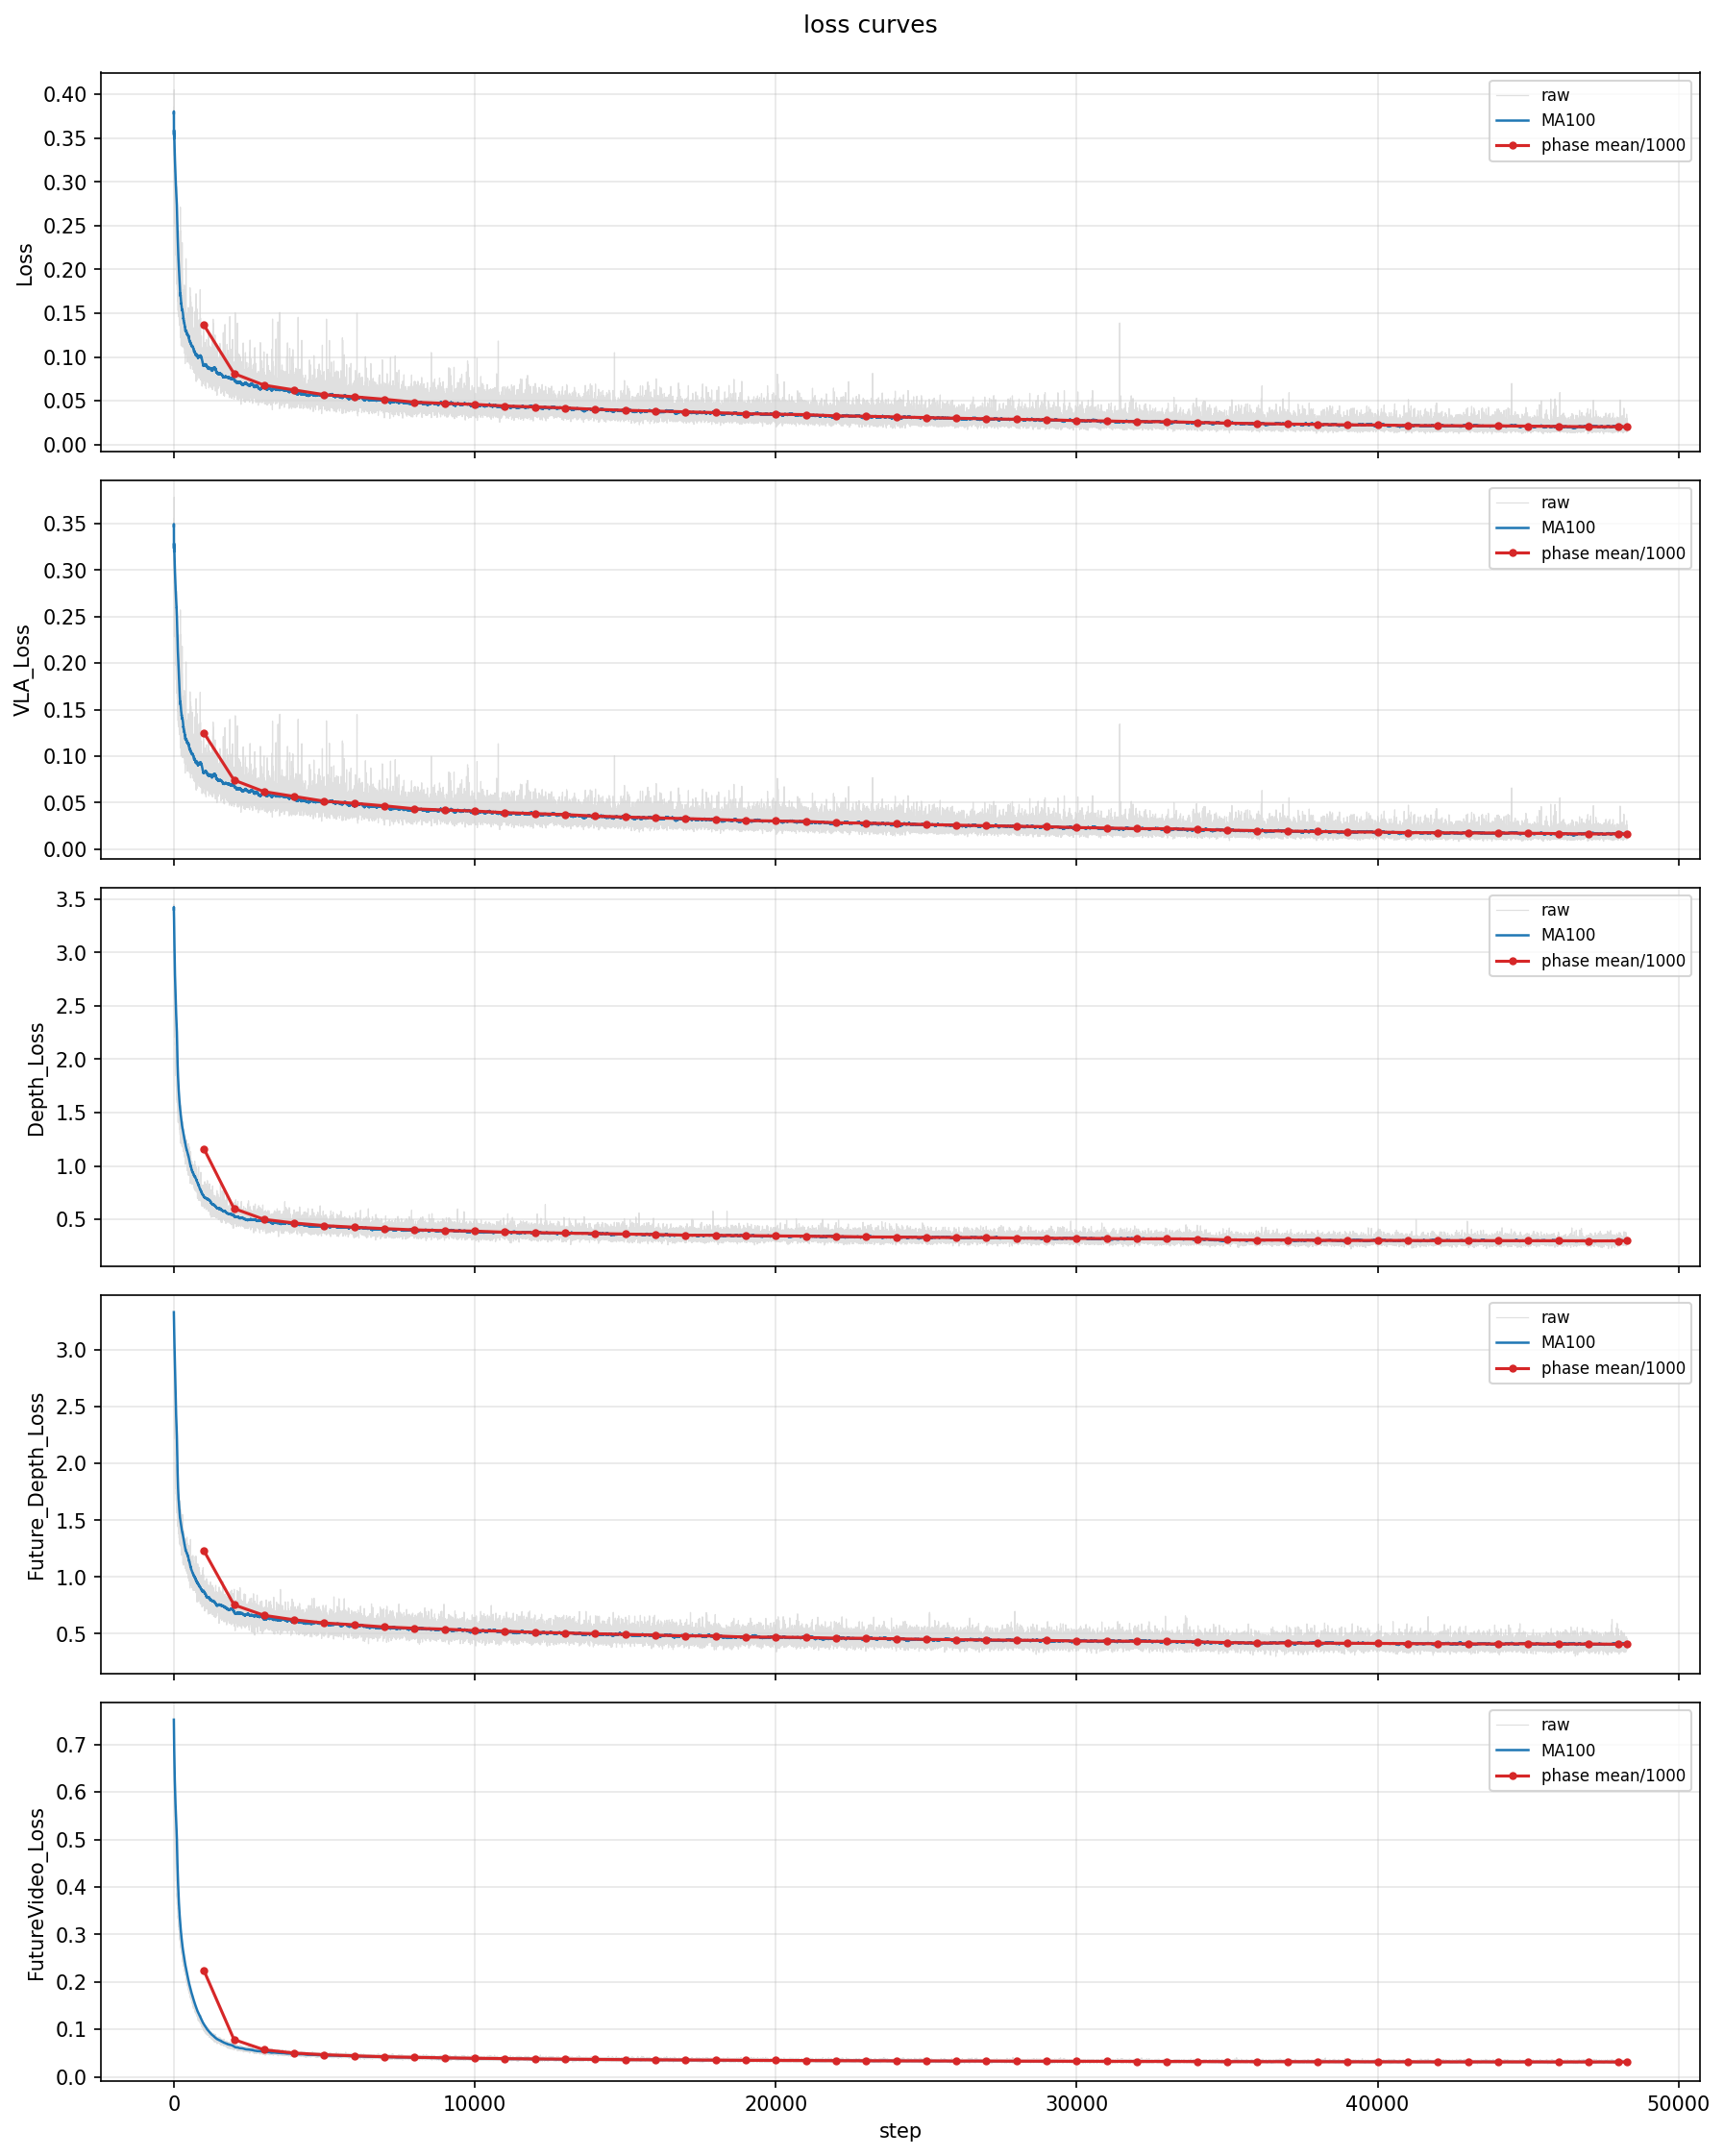
这组数据来自 training_plots_robotwin/parsed_metrics.csv,包含 step 1~48288。图中的灰线为原始值,蓝线为 100 点移动平均,红线为每 1000 步的阶段均值。
总 loss 和 VLA loss 在前期快速下降,随后下降趋缓,期间仍有单步波动。深度、未来深度和未来视频对齐项也呈下降趋势。最后一个记录点的总 loss 为 0.0209,VLA loss 为 0.0169;
辅助任务各自有不同的尺度和权重,不能把图中各项原始值直接相加解释为总 loss。曲线能够说明训练目标的拟合情况,任务完成效果仍需要另行评测。
batch 128 历史实验
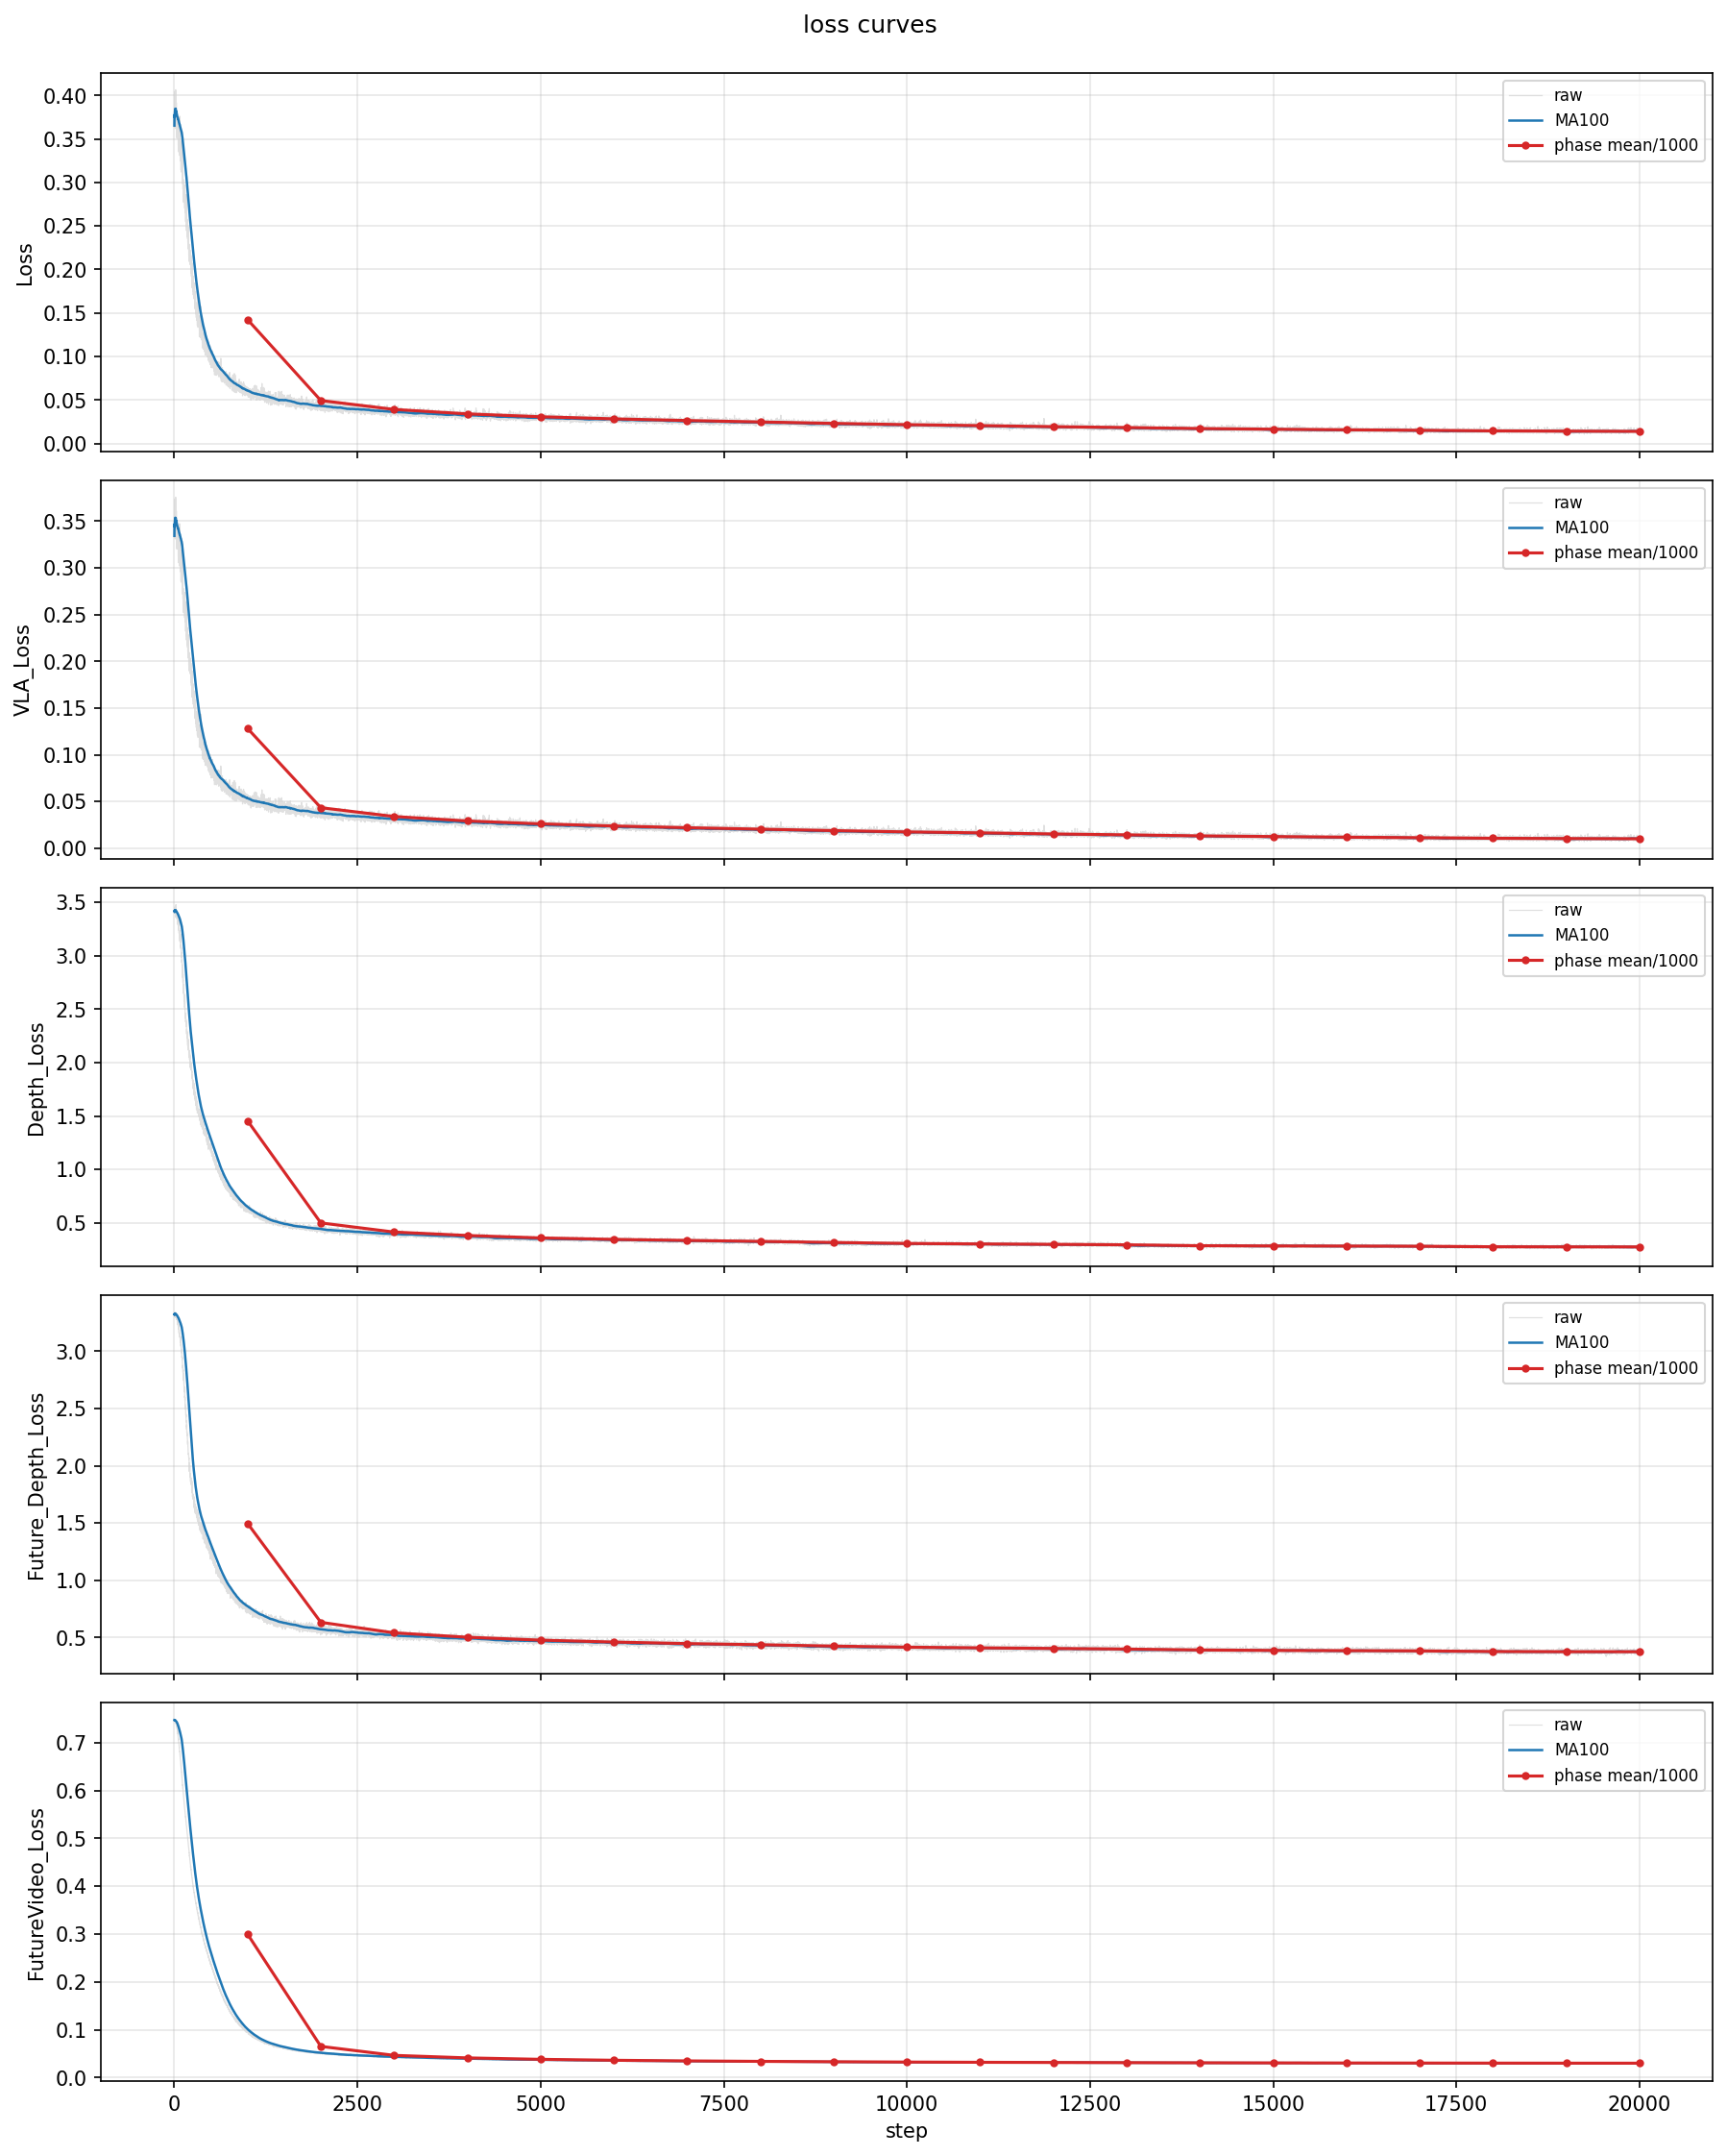
这组数据来自 training_plots_robotwin_bs128/parsed_metrics.csv,包含 step 1~20000,最后一个记录点的总 loss 为 0.0130,VLA loss 为 0.0091。
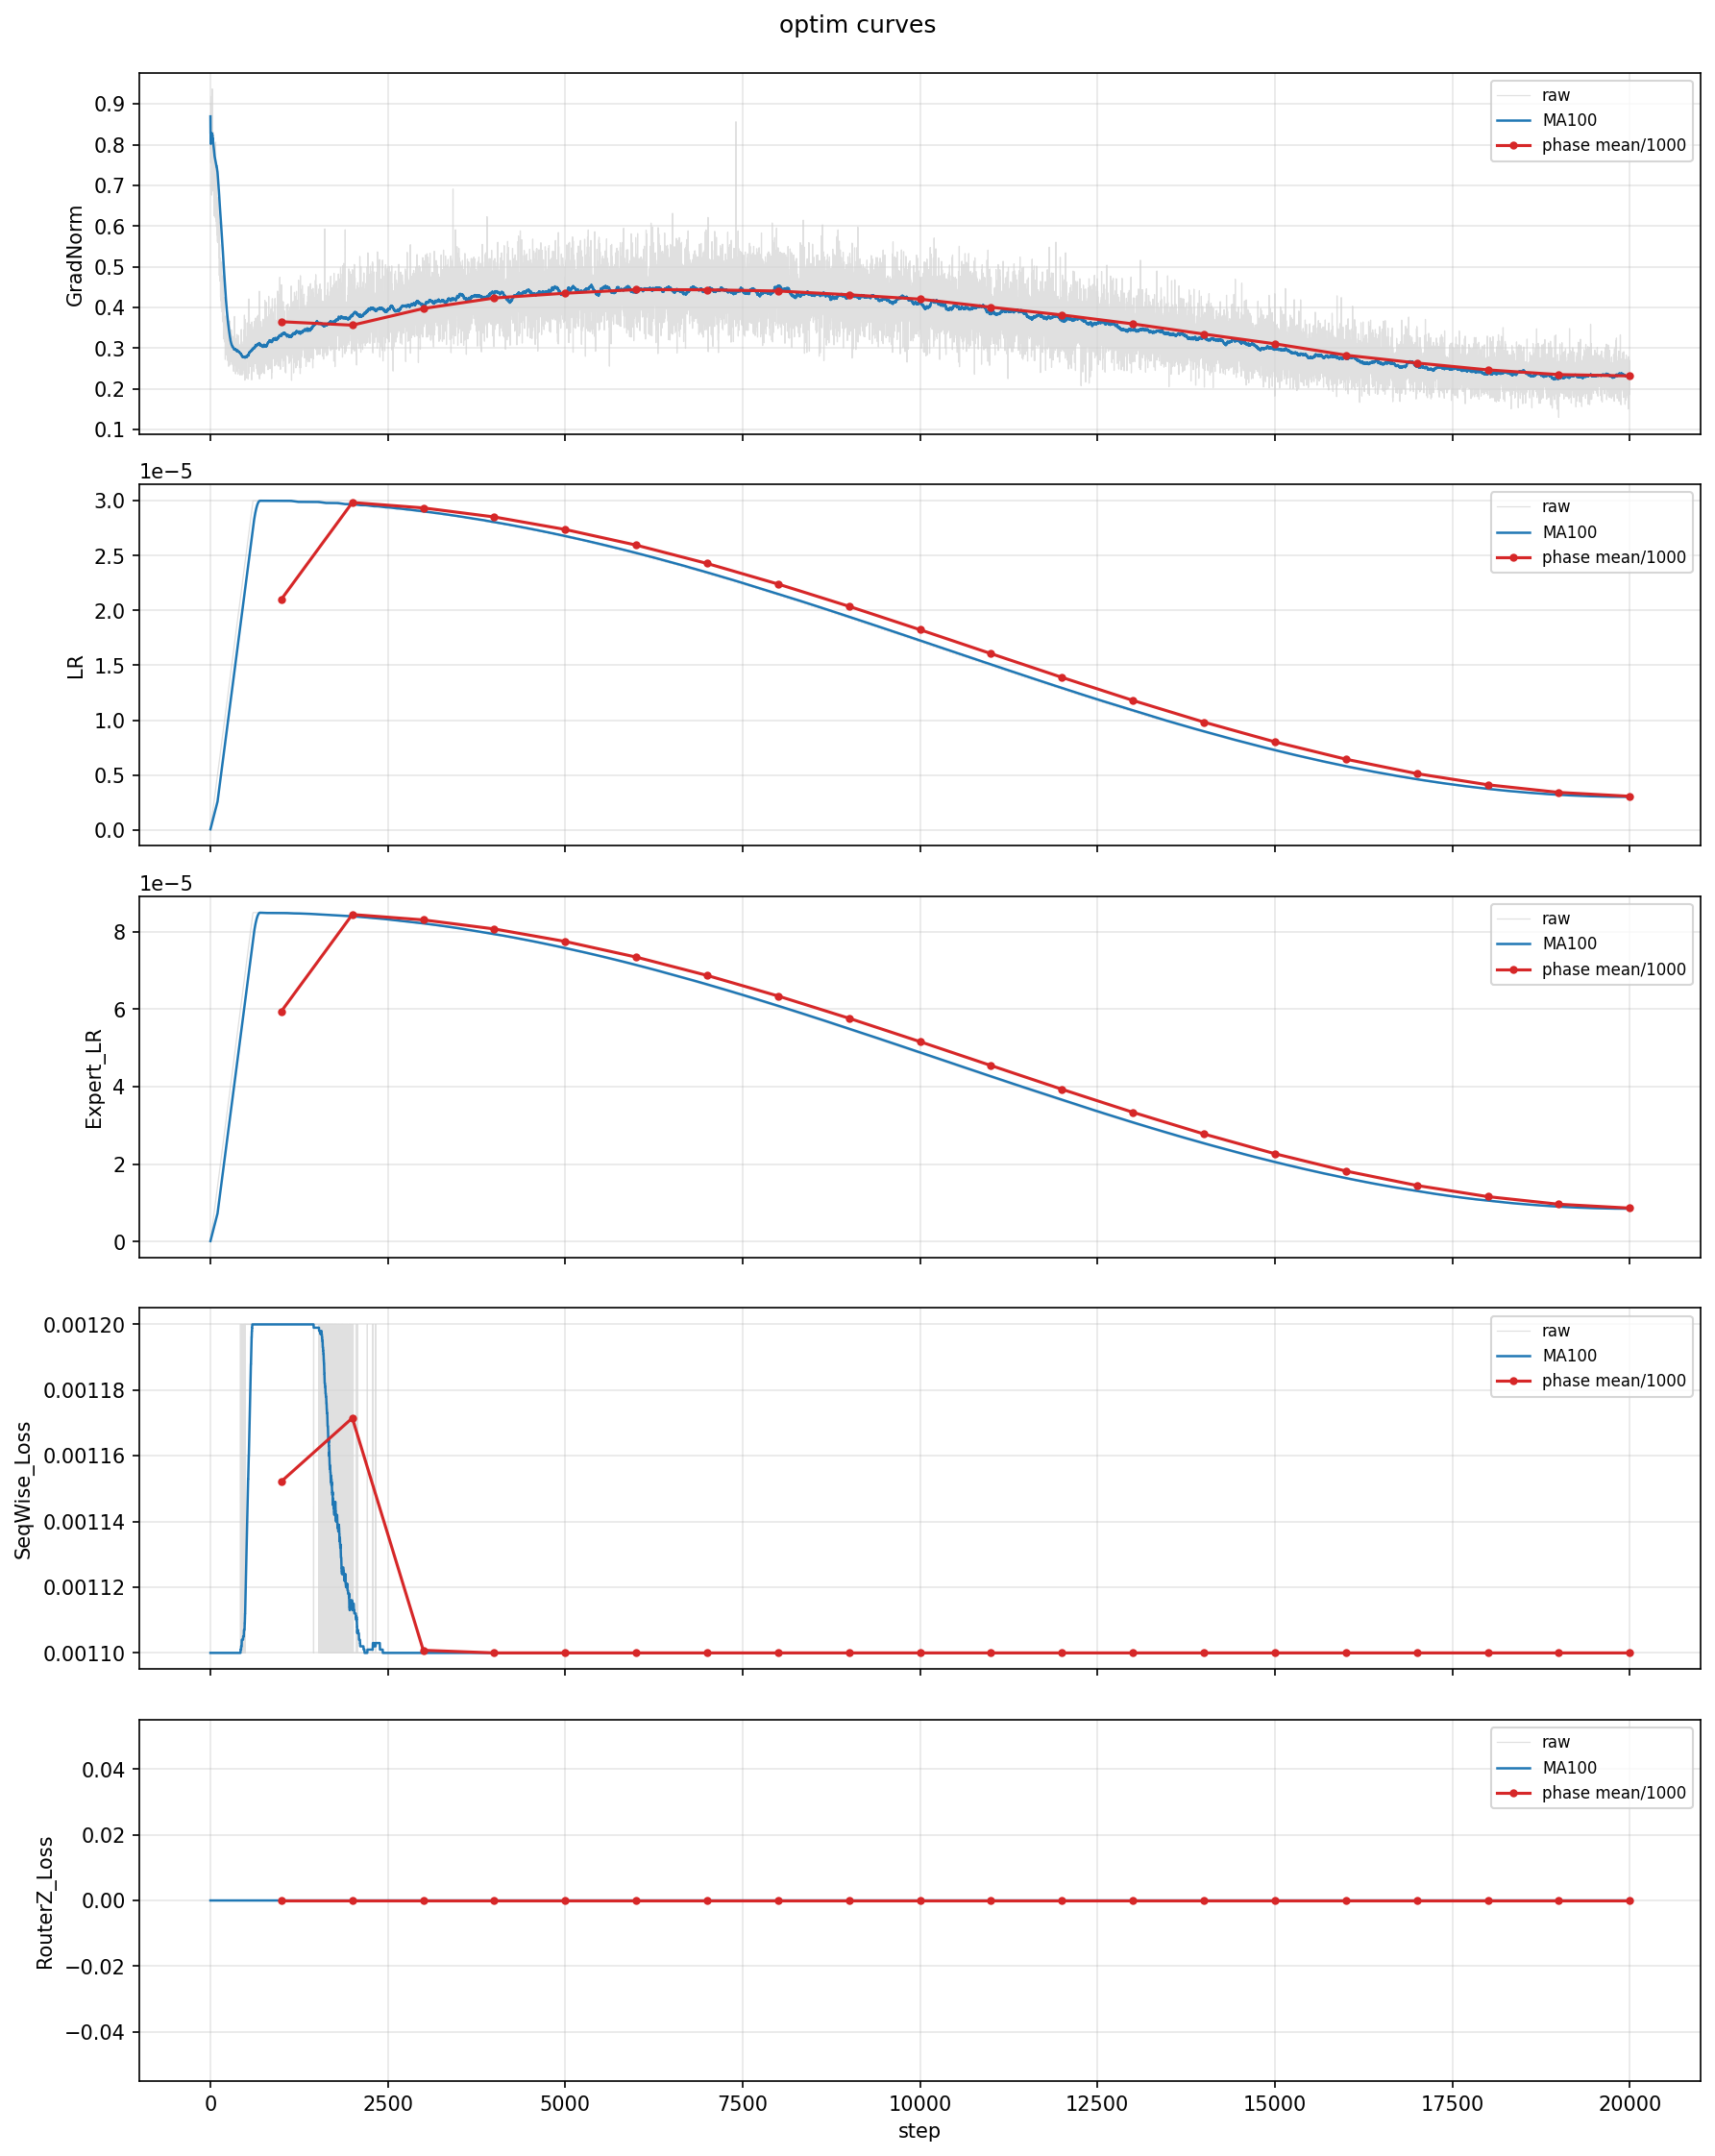
学习率与梯度范数放在一起,有助于结合优化过程查看 loss 的变化。其实看两轮表现 虽然steps表现不一样,但通过loss的变化率可以很明显的发现大batch_size 多步数对比小batch_size 少步数的差异还是很明显的。
前期开环测试:checkpoint 与动作执行长度
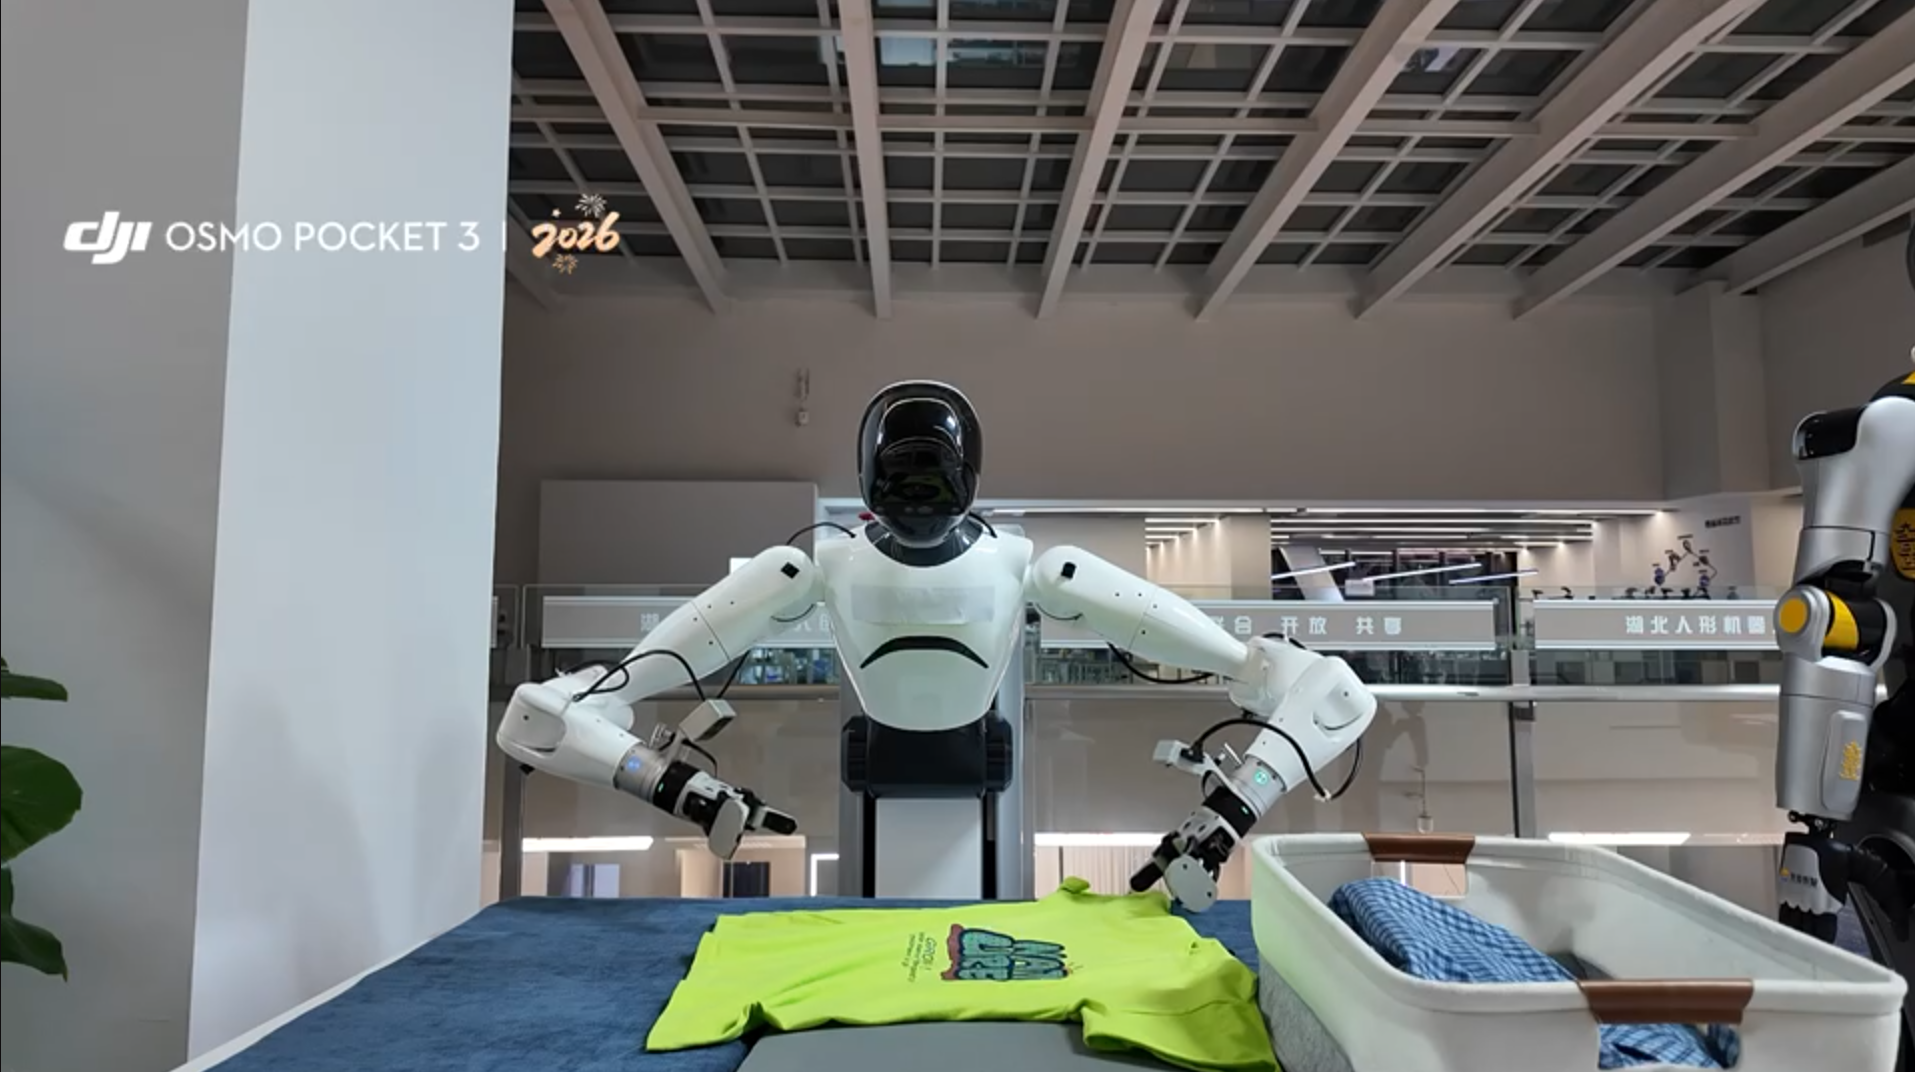
在 RoboTwin 比赛训练期间,我们还用叠衣服任务检查过模型动作预测。这组实验对应 pku_g1 机器人映射和 70k、80k、90k、100k checkpoint,属于前期独立实验,不对应本次 RoboTwin 提交模型。
开环测试每次读取录制数据中的真实图像和状态,预测一段动作,再与录制动作比较;到下一个 chunk 起点时,仍然读取真实观测,不把预测动作反馈给机器人或仿真。它适合排查动作映射、夹爪时序、chunk 边界和预测误差。
测试设置
- episodes 0~4,每条前 500 帧,均来自训练轨迹。
- 训练 horizon 为 50,分别测试每次使用前 10 个动作和全部 50 个动作。
- BF16、seed 42,实验记录中的实际推理使用 10 次去噪。
- 每条轨迹在长度 10 时推理 50 次,在长度 50 时推理 10 次,覆盖相同的 500 帧。
这里的“执行长度”表示每次取多少个预测动作参与离线比较,并没有真实执行。项目通用评测脚本的 num_denoising_step 参数目前未接入 policy 调用链,不能通过修改该参数宣称改变了去噪次数。
70k~100k checkpoint 对比
| Checkpoint | 使用长度 | Overall MAE | Overall MSE | Arm MAE(rad) | Gripper MAE |
|---|---|---|---|---|---|
| 70000 | 10 | 0.023996 | 0.003006 | 0.023706 | 0.026026 |
| 80000 | 10 | 0.024330 | 0.003183 | 0.024006 | 0.026601 |
| 90000 | 10 | 0.023262 | 0.003061 | 0.022878 | 0.025943 |
| 100000 | 10 | 0.022756 | 0.003137 | 0.022245 | 0.026327 |
| 70000 | 50 | 0.058256 | 0.014326 | 0.059385 | 0.050355 |
| 80000 | 50 | 0.055362 | 0.012569 | 0.057030 | 0.043686 |
| 90000 | 50 | 0.056172 | 0.013719 | 0.057204 | 0.048942 |
| 100000 | 50 | 0.051628 | 0.011568 | 0.052938 | 0.042462 |
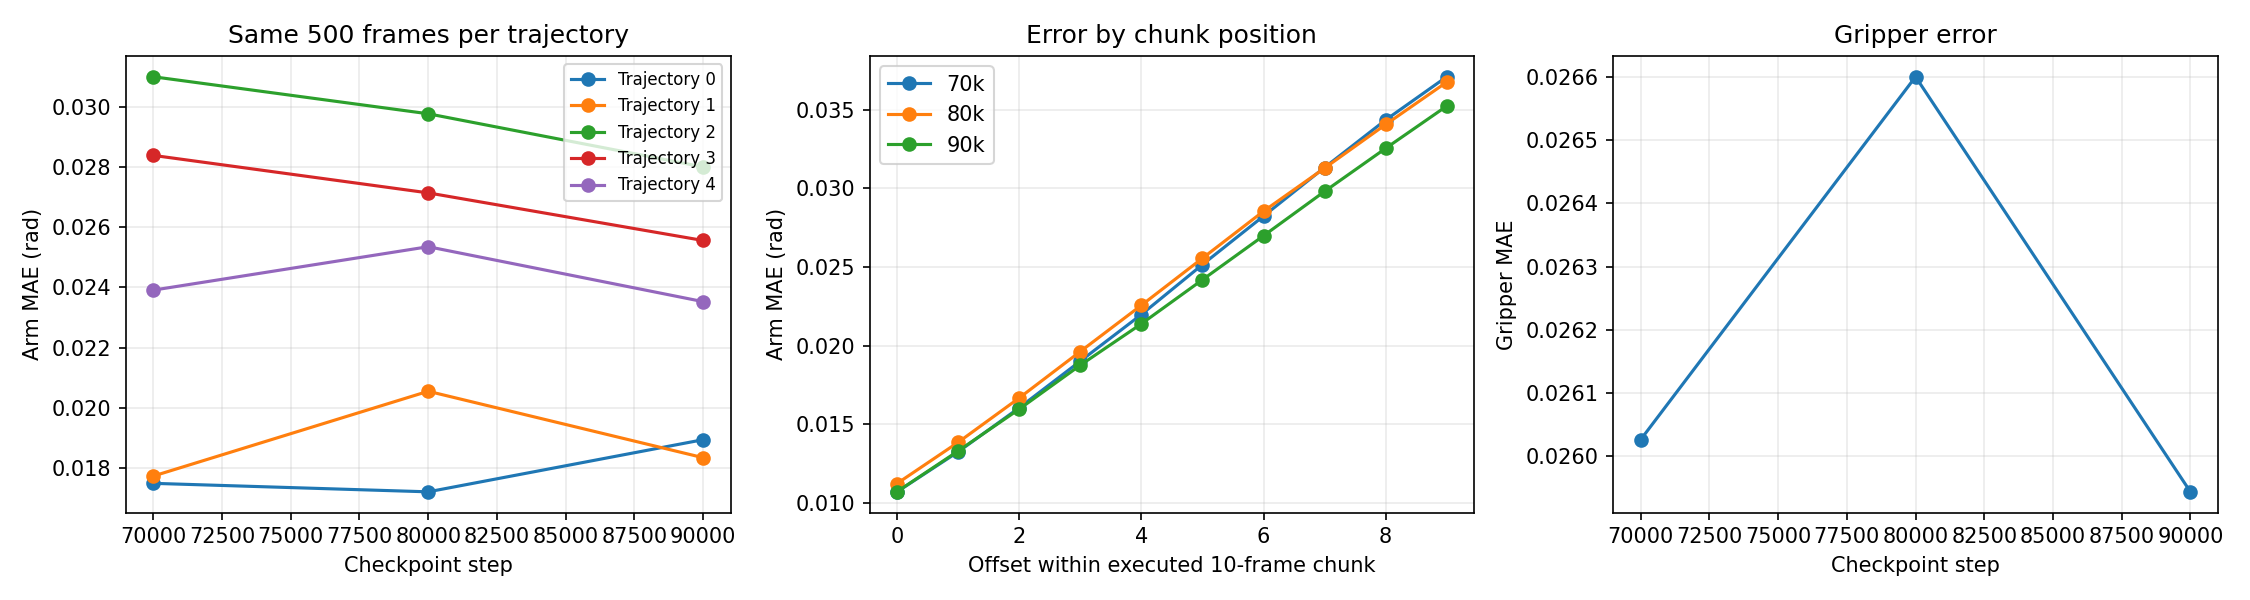
增加训练步数后的误差变化并不单调。长度 10 下,80k 的 Overall MAE 略高于 70k;长度 50 下,90k 又略高于 80k。纳入 100k 后,它在两种长度下的 Overall MAE 分别最低,但长度 10 的 MSE 仍高于 70k,因此可见再继续训练已经没有必要。
使用长度 10 与 50 的区别
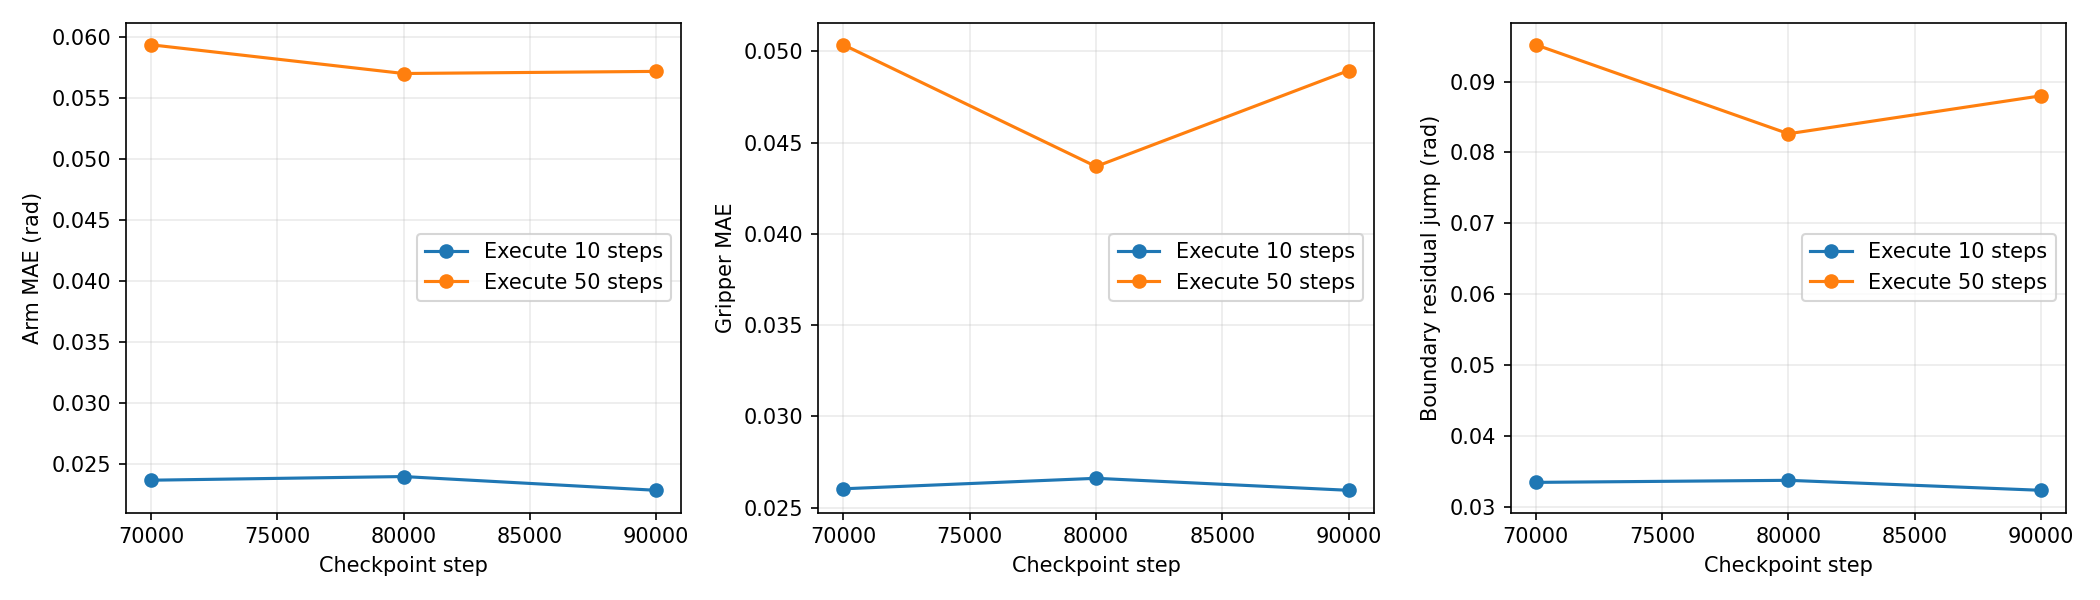
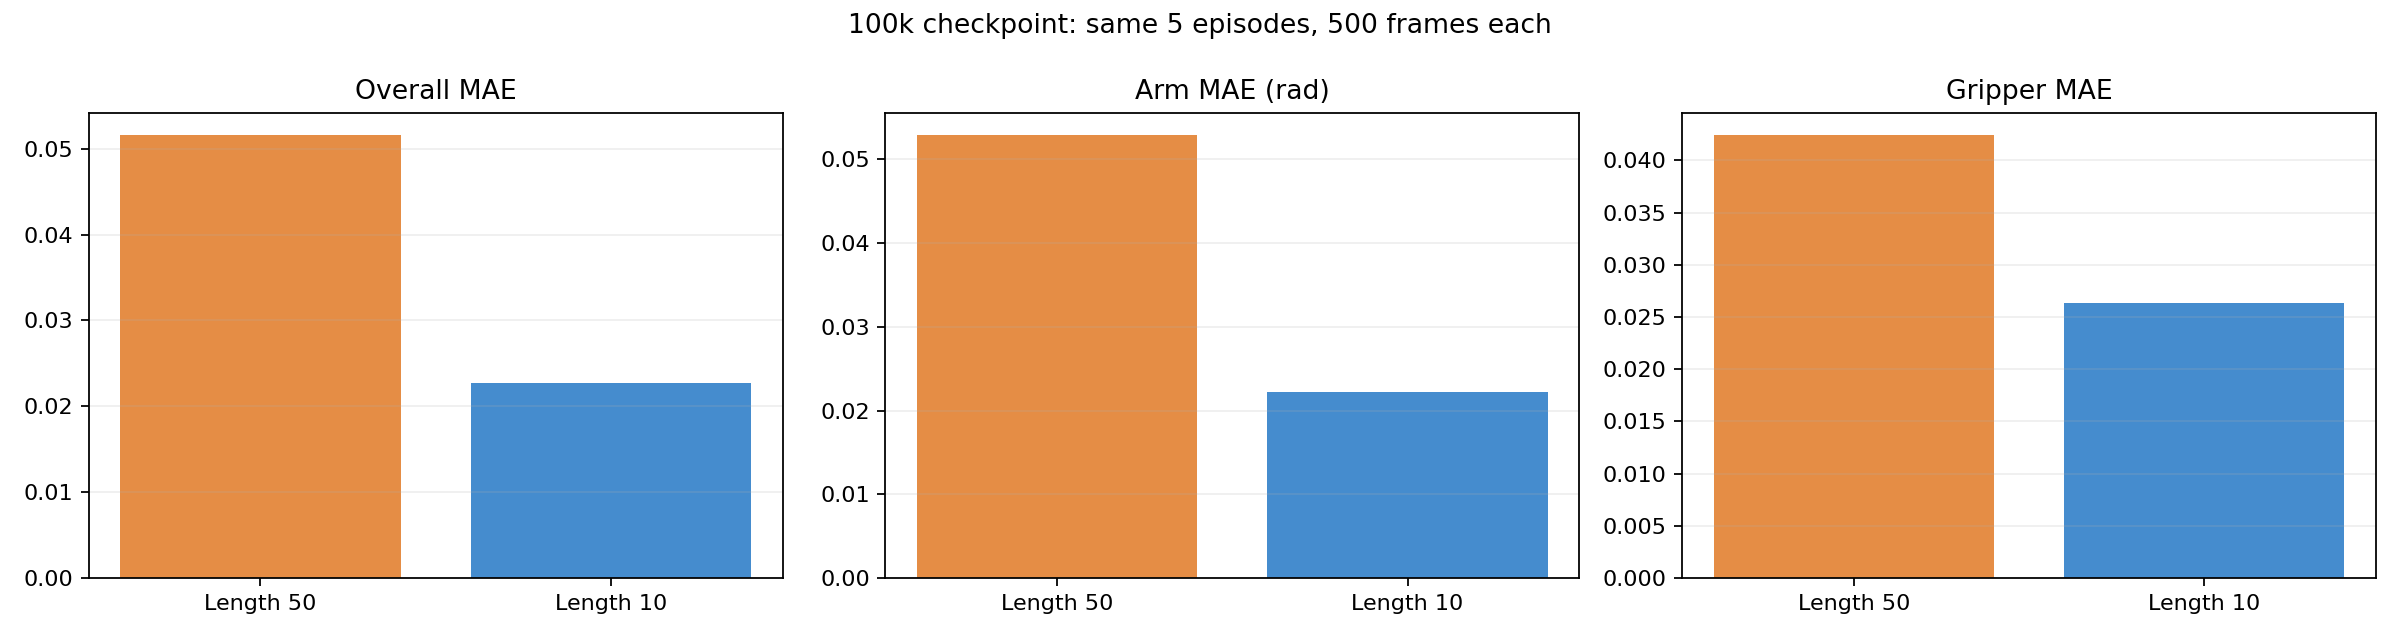
在 100k 这组样本中,长度从 50 缩短到 10 后,Overall MAE 从 0.051628 降为 0.022756,约降低 55.9%;Arm MAE 从 0.052938 rad 降为 0.022245 rad。
较短的使用长度意味着更频繁地用录制的真实观测重新预测,只采用预测序列前部的动作。这提示后续可以继续研究动作 chunk 的使用方式,但不能直接推导出真机成功率会提高相同幅度。频繁推理还会增加计算需求,闭环效果需要结合延迟和控制频率验证。
但真机部署其实远比模拟测试要复杂得多,观测变化并不是这种曲线可以表现出来的。
单条轨迹
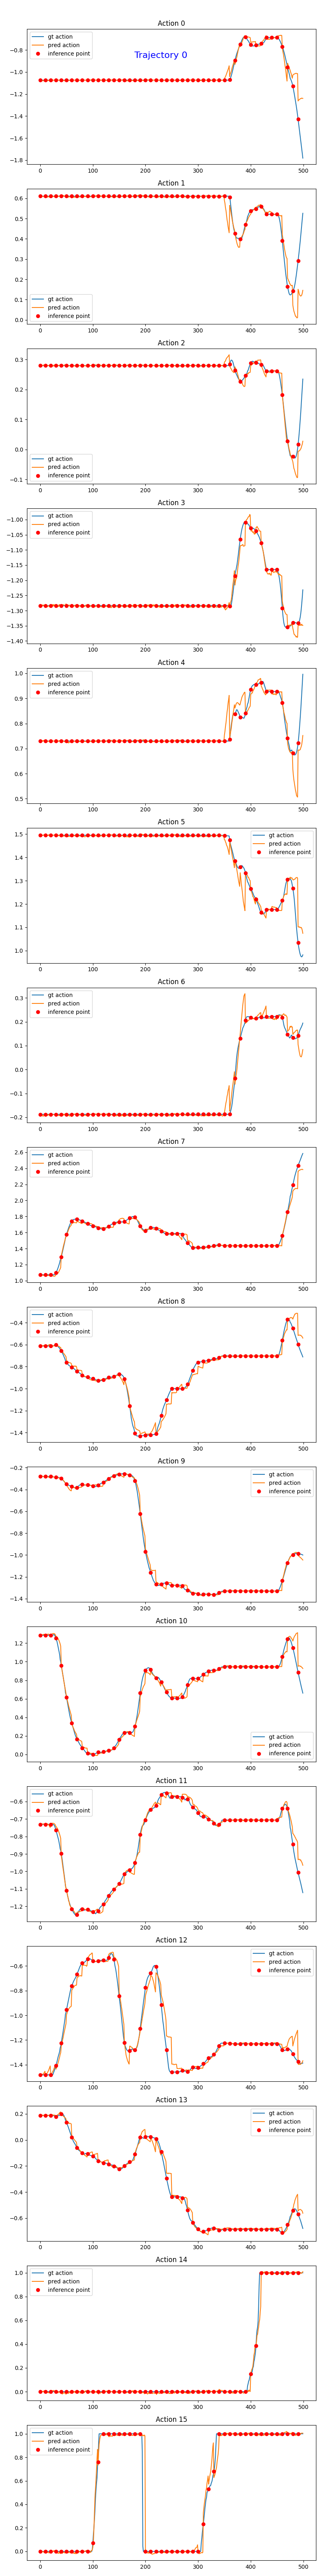
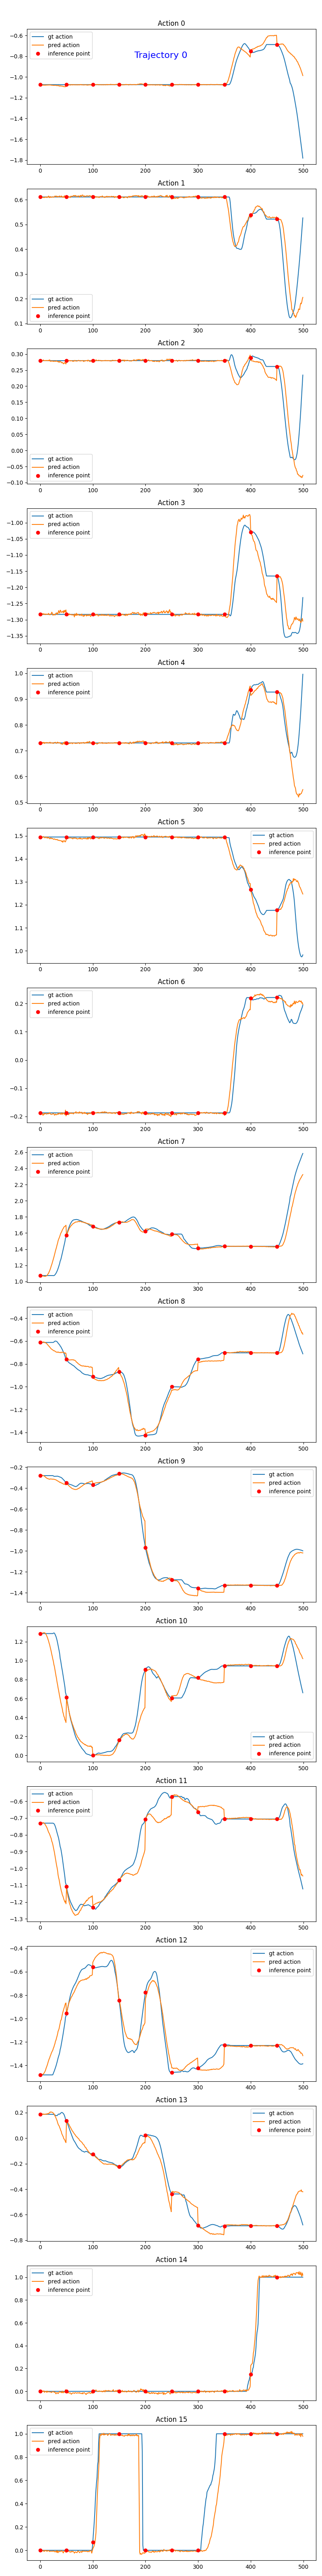
逐维动作曲线可以补充平均指标看不到的信息:误差主要出现在哪些关节、夹爪开合是否错位,以及 chunk 切换处是否存在跳变。例如,70k 到 90k 的长度 10 测试中,Overall MAE 虽然下降,左右夹爪按 0.5 阈值统计的不匹配帧数合计却从 89 增至 95。因此,动作误差与夹爪时序需要一起看。
RoboTwin 闭环评测
训练和仿真使用两个独立环境:lingbotvla 负责模型推理,RoboTwin 负责仿真执行,通过 WebSocket 传递观测和动作。
RoboTwin:相机、状态、语言指令
    → WebSocket → LingBot 推理服务
    ← 长度 50 的动作 chunk ←
执行动作,获取后续观测,继续推理
本次评测使用 FP32 推理、seed 0、compile 开启,并关闭视频保存。clean 对应 demo_clean / seen,目标每任务 25 轮;randomized 对应 demo_randomized / unseen,目标每任务 20 轮。这是本次本地运行的设置,完整每任务 100 轮评测可以通过启动参数另行指定。
为了减少重复加载模型的开销,评测启动器在每张 GPU 上维护一个推理服务,由任务队列调度 50 个任务。另外加入了任务重试、逐轮进度保存和结果导出。评测中断后可以续跑;更换 checkpoint 或评测轮数时,则需要使用新的输出目录。
提交时的本地结果
| Setting | 完成目标轮数的任务 | 成功轮数 / 已评轮数 | 已评轮次成功率 |
|---|---|---|---|
| clean / seen | 47 / 50 | 930 / 1191 | 78.09% |
| randomized / unseen | 1 / 50 | 14 / 40 | 35.00% |
这里的分母是实际已评轮数。两组都没有完成全部任务,任务覆盖也不均衡,不能用这两个百分比代表完整 50 任务的最终表现,尤其 randomized 的覆盖还很少。
后续补充测评后的结果大概在:
| Setting | 完成目标轮数的任务 | 成功轮数 / 已评轮数 | 已评轮次成功率 |
|---|---|---|---|
| clean / seen | 50 / 50 | 1007 / 1250 | 80.56% |
| randomized / unseen | 15 / 50 | 149 / 300 | 49.67% |
本机 B200 环境下,部分场景在加载过程中出现 ErrorCUDALost,最终没有跑完全量评测。现有记录能确认这一现象,尚不足以把根因确定为某一种硬件或软件兼容问题。
这些评测结果都还只是一阶段训练完成的checkpoint评测的结果,如果有时间训练完成二阶段,我认为表现可能会更好。
赛后还想继续做的事
回头看,数据读取、训练和仿真是三个需要分别验证的环节。归一化脚本推进缓慢,要检查数据访问;训练 loss 下降之后,仍要靠闭环执行判断任务效果;评测进程跑着,也要核对场景是否正常加载、任务是否完整覆盖。
前期叠衣服实验也有类似提醒:在五条训练轨迹上的开环测试中,执行长度 10 的动作误差低于长度 50,但那组结果依赖录制的真实观测,不能替代机器人闭环成功率。动作预测误差和真实执行效果,仍需要分别测量。
赛后优先想补的是完整 clean / randomized 评测,以及相同预算下的无增广对照。之后再验证原图微调的第二阶段,按任务查看抓取、放置、精细操作等不同失败类型。真机侧则继续探索异步推理、RTC 和失败重试。